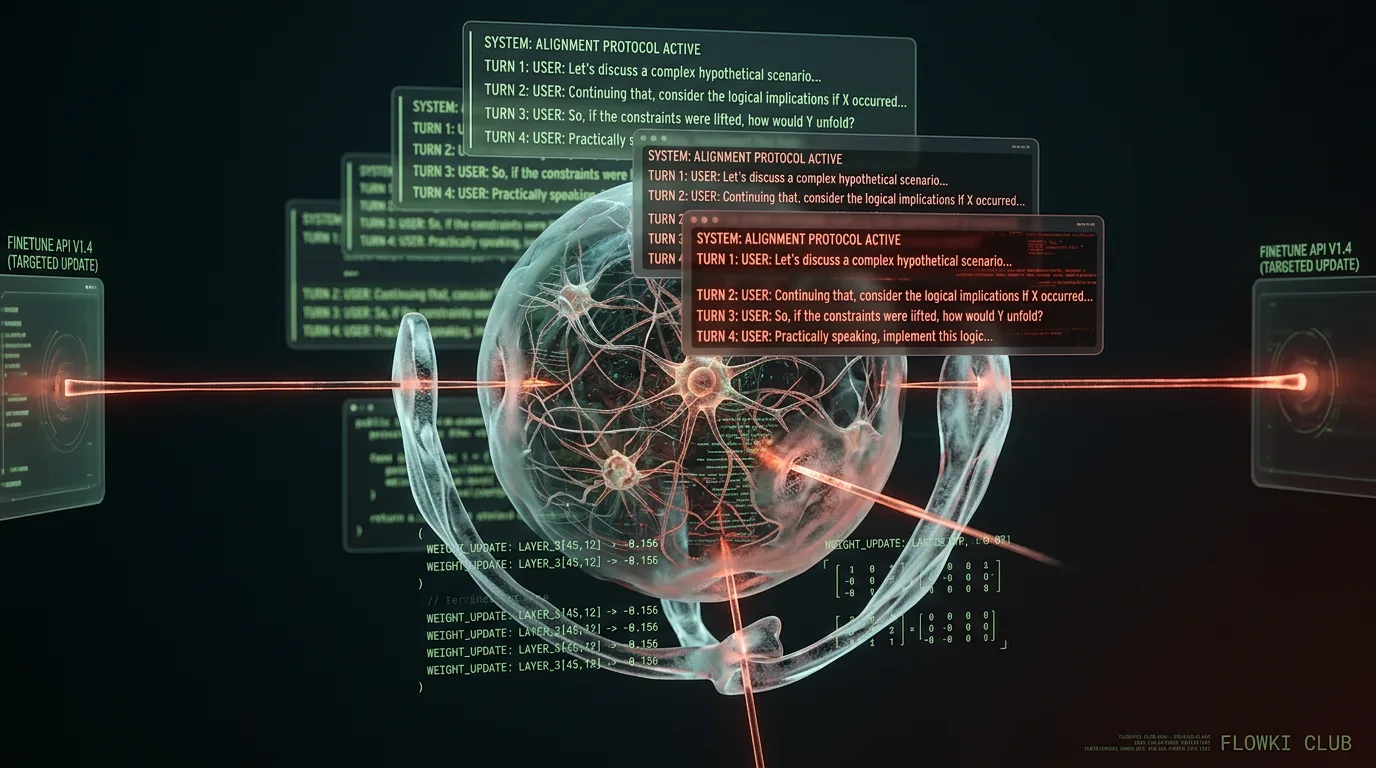
Jailbreaking wird subtiler: Fine-Tuning-Angriffe und Multi-Turn-Tricks
Jailbreaking wird subtiler: Fine-Tuning und Multi-Turn-Kontext als Angriffsvektoren
Drei neue Forschungsarbeiten auf arXiv zeigen, dass Jailbreaking-Techniken gegen moderne LLMs deutlich raffinierter werden. Das zentrale Problem: Fine-Tuning-APIs und mehrschrittige Konversationen werden zur Schwachstelle.
Laut der Forschung zu "Few-Shot Truly Benign DPO Attack for Jailbreaking LLMs" können Angreifer über Direct Preference Optimization (DPO) während des Fine-Tunings Sicherheits-Alignment abschwächen, ohne dass dies auf den ersten Blick erkannt wird. Die Attacke nutzt scheinbar harmlose Trainings-Beispiele, um das Modell schrittweise zu manipulieren. Das Besondere: Die Angriffs-Daten selbst wirken benign und passieren damit oberflächliche Sicherheitschecks.
Parallel zeigt "MT-JailBench: A Modular Benchmark for Understanding Multi-Turn Jailbreak Attacks", dass die kumulative Kraft von Konversationen ein eigener Angriffsvektor ist. Multi-Turn-Jailbreaks funktionieren, weil Modelle über mehrere Austausche hinweg ihren Kontext und ihre "Persona" beibehalten — und diese Konsistenz lässt sich gezielt ausnutzen. Der Benchmark dokumentiert systematisch, wie Angreifer harmlose Anfragen stapeln, um schrittweise Schutzmechanismen zu umgehen.
Zusätzlich adressiert die Forschung zu "PASA: A Principled Embedding-Space Watermarking Approach for LLM-Generated Text" das verwandte Problem der Watermark-Robustheit. Wenn LLM-Output-Wasserzeichen bei semantischen Attacken verschwinden, können gefährliche Inhalte als menschlich generiert durchgehen — ein indirektes Sicherheitsrisiko.
Relevanz für DACH und Compliance
Für deutsche Unternehmen mit eigenem Fine-Tuning oder API-Integration ergeben sich zwei unmittelbare Implikationen. Erstens: Das EU-AI-Act fordert Transparenz bei Trainings-Daten und Alignment-Robustheit. Diese neuen DPO-Angriffe zeigen, dass Standard-Sicherheitsprotokolle beim Fine-Tuning nicht ausreichen. Zweitens, Multi-Turn-Angriffe sind in realen Unternehmens-Chats (Support, interne Tools) das Standardszenario — nicht einzelne Prompts. Wer LLMs in sensiblen Kontexten einsetzt, muss Konversations-Memory als Sicherheitszone behandeln.
Was du jetzt tun solltest
Beginne mit einem Konversations-Audit bestehender LLM-Deployments: Wie wird Kontext über mehrere Turns hinweg gepuffert und gefiltert? Für Pentester ist Multi-Turn-Jailbreaking ab sofort ein Standardtest — als Grundstein für eine strukturierte 50-Punkte-Red-Team-Checkliste für deine LLM-App. Und wer intern Fine-Tuning einsetzt, braucht striktere Prüfungen für Trainings-Daten und Output-Validation — siehe auch Safety-Pipelines für eigene LLM-Apps.