
Was passiert
OpenAI hat zwei neue Modelle in sein Portfolio aufgenommen: GPT-6 Sol und GPT-6 Luna. Beide Varianten wurden mit ähnlichen Trainingsmethoden entwickelt wie das bereits bekannte GPT-6 Astra und adressieren das wachsende Segment preisbewusster Nutzer und Entwickler.
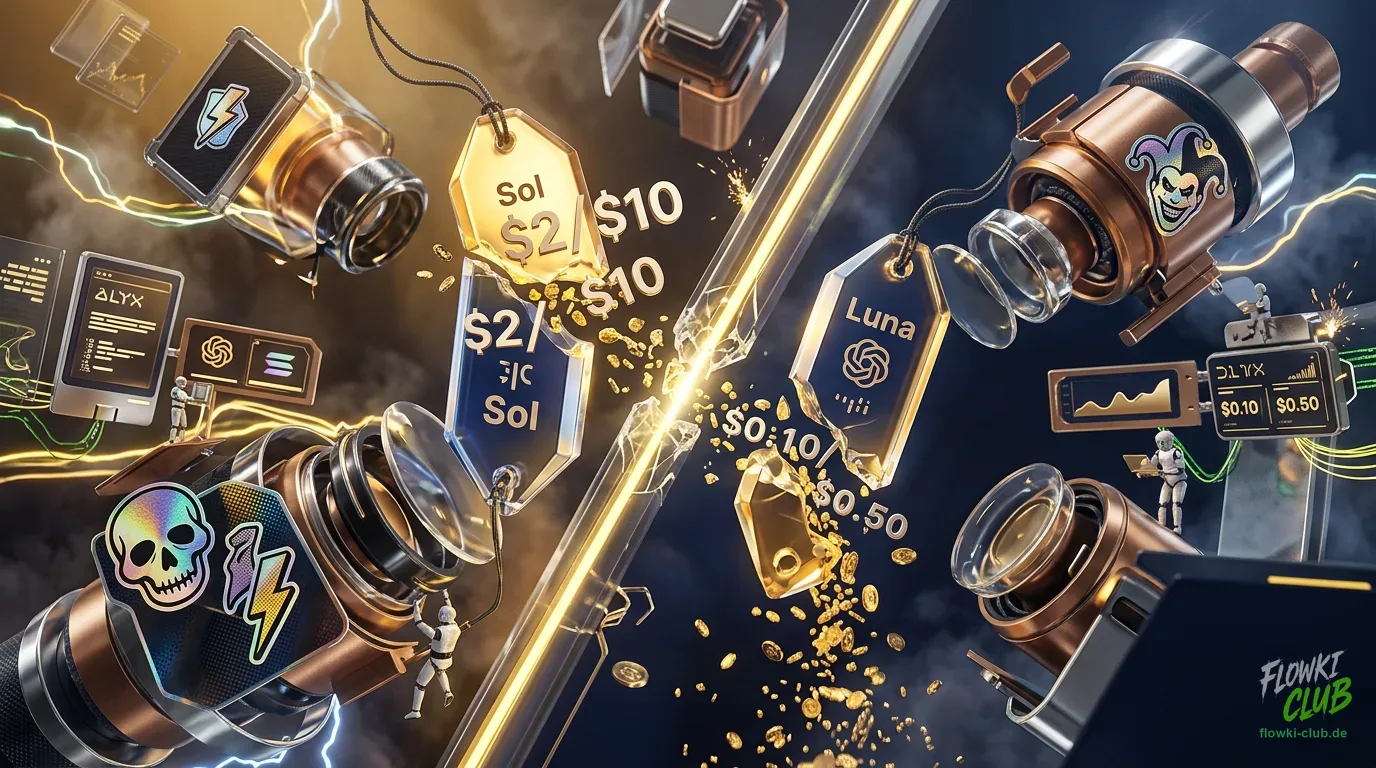
Die Preisgestaltung unterscheidet sich deutlich zwischen den beiden Modellen. GPT-6 Sol kostet $2 für Input-Tokens und $10 für Output-Tokens pro 1 Million Tokens. Luna positioniert sich noch günstiger: $0,10 für Input und $0,50 für Output pro 1 Million Tokens. Damit realisiert OpenAI die angekündigte 50-prozentige Kostenreduktion gegenüber dem vorherigen Standard-Angebot – ein merklicher Schritt auf einem Markt, auf dem Preisdruck von konkurrierenden Anbietern wie Anthropic, Google und startups wächst.
Bereits verfügbar sind beide Modelle über die OpenAI API, über ChatGPT Work (die Enterprise-Variante des Chatbots) sowie über Codex, OpenAIs spezialisierte Code-Generation-Plattform. Das bedeutet, dass Entwickler und Unternehmen unmittelbar in ihre Anwendungen einsteigen können, ohne auf weitere Release-Zyklen zu warten.
Ein weiteres Merkmal beider Modelle ist die verbesserte Implementierung von Prompt Caching. Dies ist relevant für Use-Cases, bei denen Agenten oder Systeme über längere Zeiträume mit demselben Kontext arbeiten – etwa bei Dokumentenverarbeitung, fortlaufenden Analysen oder Multi-Turn-Konversationen. Prompt Caching reduziert nicht nur die Latenz durch Zwischenspeicherung häufig genutzter Eingaben, sondern senkt auch die Kosten für redundante Token-Verarbeitung erheblich. Die Optimierung dieses Features unterstreicht, dass OpenAI die technische Infrastruktur auf Effizienz abgestimmt hat, nicht nur auf Kapazität.
Das Release erfolgt in einem Moment, in dem die Branche aggressiv um Marktanteile bei produktiven Anwendungen konkurriert. Die Kombination aus niedrigeren Preisen und verbessertem Caching-Verhalten adressiert zwei zentrale Schmerzpunkte in der produktiven Nutzung großer Sprachmodelle: Kosteneffizienz und Performance bei wiederholten Anfragen.
Einordnung
Die Veröffentlichung von Sol und Luna ist keine spontane Ankündigung, sondern Teil einer längerfristig erkennbaren Strategie OpenAIs. Mit GPT-6 Astra hatte das Unternehmen bereits ein hochperformantes Basis-Modell etabliert. Sol und Luna sind Varianten desselben Modells, die durch spezialisierte Training-Methoden leichter und kostengünstiger wurden – ein Ansatz, den Konkurrenten wie Meta (Llama-Quantization) und Mistral längst praktizieren.
Das Geschäftsmodell dahinter ist klar: Nicht alle Anwendungen benötigen die maximale Kapazität eines State-of-the-Art-Modells. Ein Chatbot für einfache Kundensupport-Fragen, ein Datenanalyse-Agent für strukturierte Informationen oder Code-Completion-Features in IDEs – sie funktionieren zuverlässig auch mit weniger ressourcenintensiven Varianten. Durch die Staffelung Sol → Luna differenziert OpenAI sein Angebot und macht es für ein breiteres wirtschaftliches Spektrum attraktiv.
Die verbesserte Prompt-Caching-Funktion ist dabei technisch bedeutsam. Für Long-Running Agents – also KI-Systeme, die über Stunden oder länger an einer Aufgabe arbeiten – waren die Token-Kosten für wiederholte Kontextinformationen ein echter Kostentreiber. Eine Anweisung "Du bist ein Finanzanalyst, arbeite immer nach diesen 50 Richtlinien" musste für jeden Request neu verarbeitet werden. Mit Cache entfällt das. Das senkt nicht nur die Gesamtkosten pro Agent-Session merklich, sondern verbessert auch die Antwortgeschwindigkeit – ein Vorteil, der sich direkt in besserer User Experience übersetzt.
Gegenüber dem vorherigen Angebot bedeutet das: Unternehmen können ihre Inferenz-Ausgaben senken, ohne die Qualität der Ergebnisse aufzugeben – vorausgesetzt, sie nutzen die passende Modell-Variante für ihren Use-Case. Das erhöht auch die wirtschaftliche Nachvollziehbarkeit von LLM-Einsätzen in der Produktion.
Was das bedeutet
Die entscheidende Konsequenz ist nicht die Preisreduktion isoliert, sondern dass diese Preisveränderung den Weg für Produktionsanwendungen auf breiter Basis ebnet. Bei früheren Modell-Generationen waren LLMs für viele Organisationen ein Experiment – Budget für Proof-of-Concepts war verfügbar, aber Skalierbarkeit auf hunderte oder tausende User gleichzeitig schien ökonomisch unerreichbar.
Mit Luna ($0,10/$0,50 pro 1M Tokens) verschiebt sich diese Mathematik. Ein Echtzeit-Übersetzer, eine Schreibhilfe in Office-Tools, ein produktiver Code-Generator – diese Szenarien rechnen sich nun auch bei hohem Durchsatz. Unternehmen können KI nicht mehr als Premiumfeature für wenige Power-User betreiben, sondern als breite Produktfunktion ausrollen. Das erhöht den Wettbewerbsdruck auf Konkurrenten und beschleunigt den Shift von "Haben wir ein KI-Feature?" zu "Wie integrieren wir KI überall standardmäßig?" Die Kombination aus tieferer Preisstaffelung, verbessertem Caching und multi-Channel-Verfügbarkeit (API, ChatGPT, Codex) macht OpenAI damit zur flexibleren Infrastruktur-Wahl für verschiedenste Anwendungsklassen – nicht nur für die Spitze des Leistungsspektrums.